A maioria dos relatórios de causa raiz responde o QUE aconteceu. Mas como fazer análise de causa raiz de chamado de verdade é responder o PORQUE — e é nos silêncios entre as interações, não nos eventos, que mora a melhoria real. Veja por que o gap de resposta é o número que ninguém mede.
⚡ Versão de 30 segundos
- RCA tradicional descreve a sequência de eventos do chamado (o sintoma). A causa raiz quase sempre está no intervalo entre eventos — o gap de resposta — que essa abordagem não enxerga.
- Gap de resposta = o tempo morto entre uma ação e a próxima. É onde o chamado ‘dorme’: esperando triagem, aprovação, retorno do cliente ou um técnico que esqueceu.
- Como fazer análise de causa raiz de chamado de verdade: reconstrua a linha do tempo, marque cada transição, meça o silêncio entre elas e ataque o maior gap — não o evento mais visível.
- No exemplo real do chamado #2685787, o gap de resposta foi de ~29 dias. O ‘evento’ (a solução) levou minutos; o silêncio levou quase um mês.
- O Relatório de Causa-Raiz da Service Up (módulo do Copilot no Znuny) já faz isso automático: linha do tempo + análise de gaps + causa raiz por IA (DeepSeek), em 8 seções de PDF por chamado.
O problema: seu RCA está descrevendo o sintoma
Pegue qualquer relatório de causa raiz de chamado que você já leu. Provavelmente ele diz algo como: ‘o chamado foi aberto, passou pela triagem, foi escalado para o N2, recebeu uma solução e foi fechado’. Tudo verdade. E tudo inútil para melhorar o processo.
Isso é a descrição do QUE aconteceu — a cadeia de eventos. É o sintoma. Um chamado que demorou 30 dias para fechar com essa narrativa parece ter seguido o fluxo certo, só que devagar. Mas ‘devagar’ não é uma causa raiz. É um efeito.
O erro estrutural é olhar para os eventos (as caixinhas da linha do tempo) em vez de olhar para os espaços entre eles. A causa raiz de um chamado lento quase nunca está em quanto tempo a equipe levou para AGIR. Está em quanto tempo o chamado ficou parado SEM ninguém agir.
- RCA do sintoma: ‘levou 30 dias para resolver’ → conclusão genérica ‘precisamos ser mais rápidos’.
- RCA da causa: ‘ficou 29 dias parado entre a triagem e a primeira resposta técnica’ → conclusão acionável ‘a fila X não tem dono nas primeiras 48h’.
- O primeiro vira um slide. O segundo vira um SLA, uma regra de roteamento ou um alerta.
O que é o ‘gap de resposta’ (e por que ninguém mede)
Gap de resposta é o intervalo de silêncio entre dois eventos de um chamado: o tempo em que nada foi registrado, ninguém respondeu e o chamado simplesmente esperou. É o oposto do tempo de trabalho — é o tempo de espera.
Ninguém mede porque os relatórios padrão somam durações de etapas, não os vazios entre elas. O sistema sabe quando o N2 pegou o chamado e quando devolveu a solução; ele raramente destaca os 29 dias em que o chamado ficou na fila antes de alguém olhar. Esse vazio não tem um ‘responsável’ óbvio, então some do radar.
E é justamente aí que mora a melhoria. Otimizar o evento (a equipe resolver em 8 minutos em vez de 12) tem ganho marginal. Eliminar o gap (o chamado não dormir 29 dias antes de alguém pegar) tem ganho de ordem de grandeza.
- Gaps típicos: espera de triagem, espera de aprovação, espera de retorno do cliente, chamado ‘esquecido’ numa fila sem dono, reabertura silenciosa.
- Cada gap tem um culpado de processo diferente — e cada um pede uma correção diferente. Por isso medir ‘o tempo total’ não ajuda: ele mistura todos os gaps num número só.
- A pergunta certa não é ‘quanto demorou?’. É ‘onde, exatamente, ele travou?’.
A operação inteira · painel de causa-raiz
Recriação do painel real (Ferramentas → AI Copilot · Relatório de Causa-Raiz).
Exemplo: a linha do tempo do chamado #2685787
Considere um caso real do módulo. O tempo total de resolução chamava atenção, mas o número sozinho não dizia nada. A análise de gaps reconstruiu a linha do tempo e isolou onde o tempo realmente foi embora.
Repare na coluna ‘gap’: a solução técnica em si foi rápida. O que destruiu o SLA foi um único intervalo de silêncio de cerca de 29 dias entre a triagem e a primeira ação técnica. Esse é o gap de resposta. Tudo o resto é ruído.
- Dia 0 — Abertura: chamado criado e classificado. Gap até o próximo evento: ~0.
- Dia 0 — Triagem: roteado para a fila técnica. Gap até o próximo evento: ~29 dias (← AQUI está a causa raiz).
- Dia 29 — Primeira resposta técnica: alguém finalmente pega o chamado. Gap: minutos.
- Dia 29 — Solução e fechamento: resolvido. Gap: ~0.
- Diagnóstico do sintoma: ‘chamado de 29 dias’. Diagnóstico da causa: ‘a fila técnica não tinha dono nem alerta de chamado parado — ficou 29 dias invisível’.
Como fazer análise de causa raiz de chamado pela ótica dos gaps
Aqui está o método prático de como fazer análise de causa raiz de chamado, independente da ferramenta. Ele troca a pergunta ‘o que aconteceu?’ por ‘onde travou?’. É esse giro que separa um relatório descritivo de um RCA acionável.
O segredo é tratar o silêncio como dado, não como ausência de dado. Um chamado parado por 29 dias não é ‘falta de informação’ — é a informação mais importante do chamado.
- 1. Reconstrua a linha do tempo evento a evento (abertura, triagem, escalações, respostas, esperas por cliente, fechamento, reaberturas).
- 2. Marque cada transição com timestamp e calcule o gap entre uma e a próxima.
- 3. Ordene os gaps do maior para o menor. O maior gap é seu suspeito número um — não o evento mais demorado.
- 4. Classifique cada gap por TIPO de espera (triagem, aprovação, cliente, fila sem dono). O tipo aponta para a correção.
- 5. Generalize: o mesmo tipo de gap se repete em vários chamados do mesmo serviço? Então não é um caso isolado, é um defeito de processo.
- 6. Só então escreva a causa raiz — uma frase que aponta o gap e o porquê dele, não a duração total.
De um chamado para o serviço inteiro: a visão agregada
Um gap em um chamado é um incidente. O mesmo gap repetido em dezenas de chamados do mesmo serviço é um diagnóstico organizacional. É por isso que a análise de causa raiz não pode parar no chamado individual.
No painel agregado da Service Up, os chamados do período são agrupados por serviço vinculado, com a causa raiz da IA como detalhe de cada grupo. Aí os padrões aparecem: um serviço cujos chamados sistematicamente travam na aprovação, outro cujos gaps estão sempre no retorno do cliente. Cada padrão é uma alavanca de melhoria diferente.
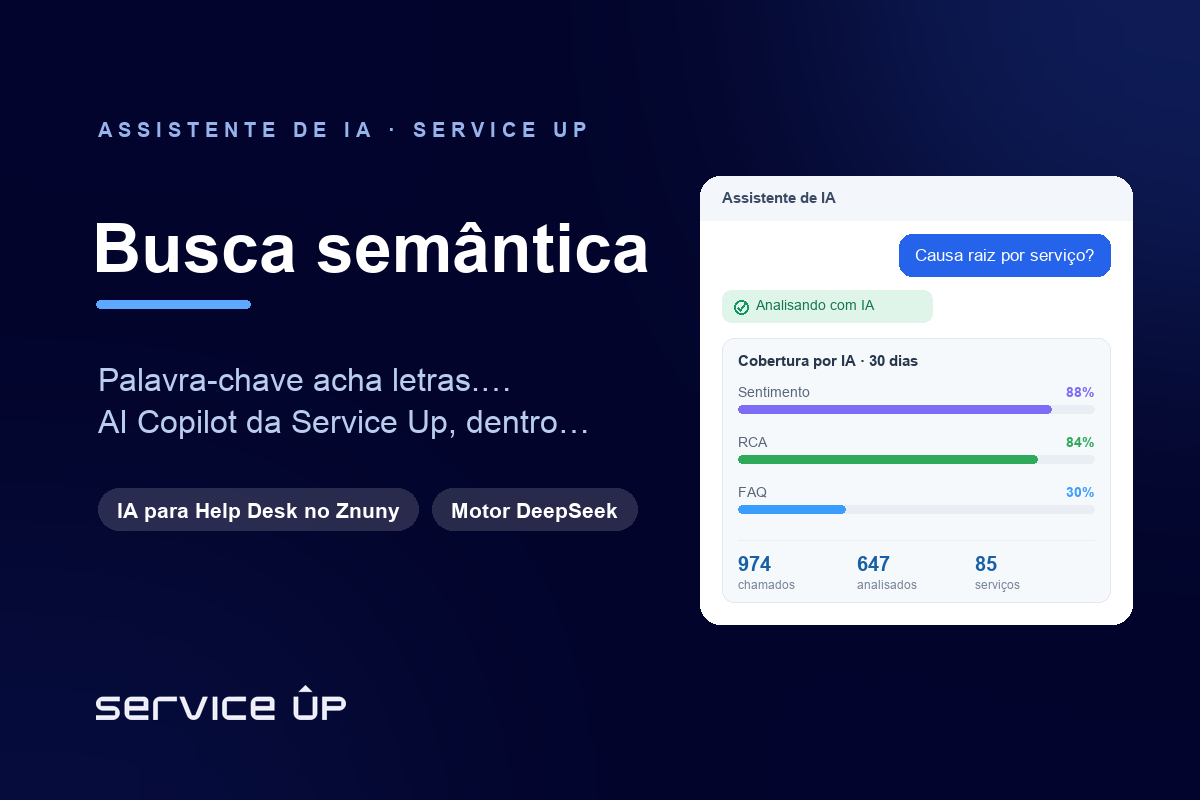
Os números do período tornam isso concreto: 974 chamados, 647 analisados (66% de cobertura), distribuídos por 85 serviços. Sinais úteis aparecem de imediato — 182 chamados sem serviço vinculado (um gap de cadastro, não de atendimento) e ‘Consultoria::Dúvida’ como serviço de maior volume (142). Cada agrupamento é uma hipótese de causa raiz esperando ser confirmada.
- Por chamado: onde ESTE travou.
- Por serviço: onde a CATEGORIA inteira costuma travar.
- Sem serviço vinculado (182 chamados): um gap antes do gap — falta de vínculo que cega a análise agregada.
Onde a Service Up entra: o Relatório de Causa-Raiz
Tudo isso é trabalho manual demorado se feito chamado a chamado. O Relatório de Causa-Raiz é o módulo do AI Copilot da Service Up, dentro do Znuny, que automatiza exatamente esse método. Ele lê o chamado, reconstrói a linha do tempo, mede os gaps e escreve a causa raiz — usando o motor DeepSeek (deepseek-chat).
Por chamado, ele gera um PDF completo com 8 seções: resumo executivo, linha do tempo, análise de gaps + causa raiz, sentimento, status técnico, recomendações, métricas e conclusão. A seção de gaps é o coração — é ela que expõe o intervalo de 29 dias do #2685787 em vez de só dizer ‘demorou’.
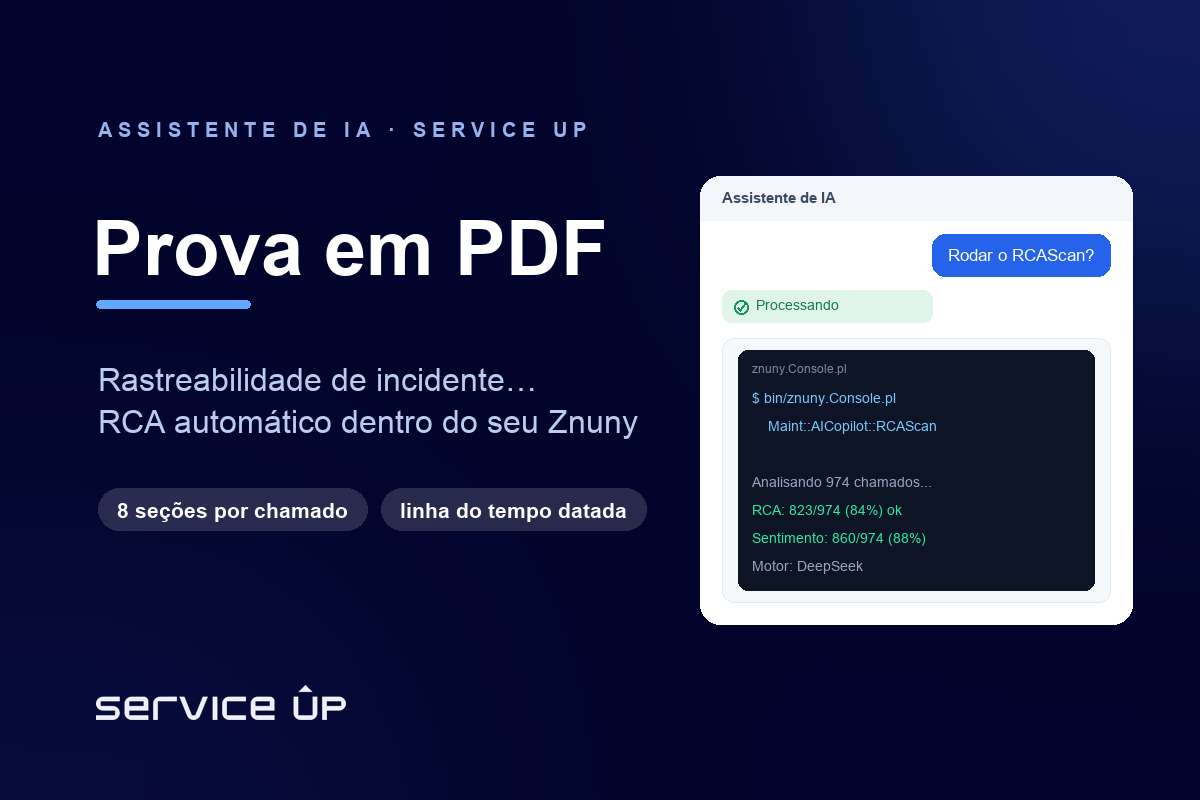
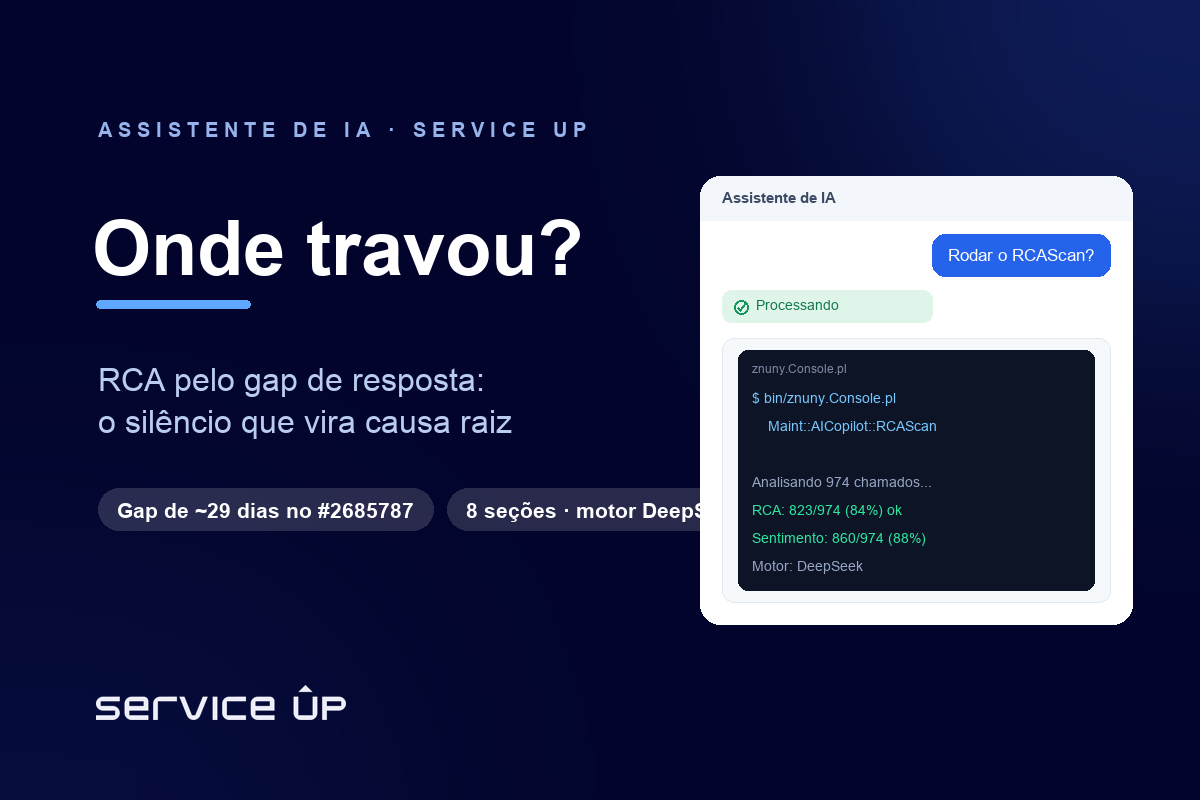
O processamento roda sob demanda (‘Processar agora’) ou em lote pelo console (bin/znuny.Console.pl Maint::AICopilot::RCAScan). E vale a tese de sempre: a IA não substitui o analista. Ela acelera a reconstrução e a leitura dos gaps; o humano decide o que fazer com eles. A IA acelera; o humano decide.
- 8 seções no PDF por chamado — gaps + causa raiz no centro.
- Painel agregado por serviço com a causa raiz da IA como detalhe.
- Motor DeepSeek; execução via ‘Processar agora’ ou Maint::AICopilot::RCAScan no console.
- É um módulo DA Service Up (parceira Znuny/OTOBO). Quer ver no seu Znuny? Fale com a gente.
🔧 Para os técnicos
Abra só o que te interessa.
Como o gap de resposta é calculado tecnicamente na linha do tempo?
A partir dos eventos do histórico do chamado (abertura, triagem, mudanças de estado/fila, artigos de resposta, esperas por cliente, fechamento e reaberturas), cada evento recebe um timestamp. O gap é a diferença entre o timestamp de um evento e o do anterior — ou seja, o tempo em que o chamado existiu sem nenhum registro novo. Em vez de somar as durações de trabalho, a análise olha para esses intervalos de silêncio: é o maior deles que tende a ser o suspeito primário da causa raiz. No #2685787, esse raciocínio isola um gap de ~29 dias entre triagem e primeira resposta técnica.
Por que medir gaps em vez do tempo total ou do tempo vs SLA?
Tempo total e tempo vs SLA dizem QUE o chamado estourou, mas misturam todos os intervalos num número único — você não sabe se o estouro veio de espera de cliente, de fila sem dono ou de aprovação travada. O gap decompõe esse total por intervalo e por tipo de espera, transformando um efeito agregado em uma causa específica e acionável. SLA é o termômetro; o gap é o diagnóstico. O Copilot também faz tempo vs SLA, mas o RCA usa os gaps para explicar o PORQUE do estouro.
Como rodar a análise em lote e qual o motor por trás?
Pontualmente, use ‘Processar agora’ na interface do chamado. Em lote, rode no console: bin/znuny.Console.pl Maint::AICopilot::RCAScan — que varre os chamados elegíveis do período e gera os RCAs. O motor de geração é o DeepSeek (deepseek-chat). No último período de 30 dias isso resultou em 647 de 974 chamados analisados (66% de cobertura), com índice de RCA de 84%, sobre 85 serviços. A IA reconstrói e redige; a decisão sobre cada causa raiz continua humana.
O que significam os 182 chamados ‘No linked service’ para a análise de causa raiz?
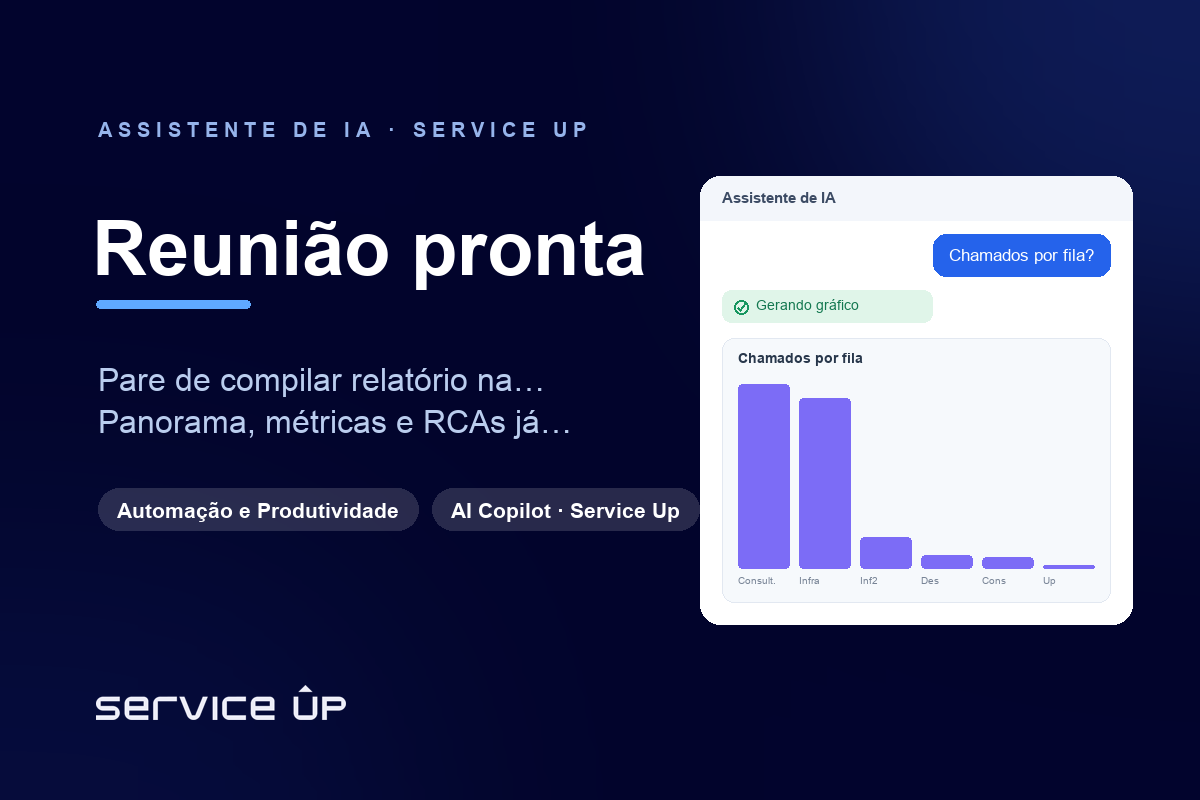
É um gap antes do gap de resposta: 182 chamados sem serviço vinculado não entram no agrupamento por serviço do painel agregado, então seus padrões de causa raiz ficam cegos na visão organizacional. Na prática, é um defeito de cadastro/roteamento que reduz a granularidade analítica. Corrigir o vínculo de serviço é, em si, uma recomendação de RCA — melhora tanto o detalhamento do relatório quanto a confiabilidade da visão por serviço (hoje sobre 85 serviços, sendo ‘Consultoria::Dúvida’ o de maior volume com 142 chamados).
Este módulo é parte do AI Copilot da Service Up
Somos especialistas em ITSM e help desk (parceira Znuny/OTOBO). O AI Copilot já roda no nosso ambiente — e pode rodar no seu.
Quer ver onde seus chamados realmente travam?
Converse com o nosso time comercial e veja a IA aplicada ao seu atendimento.
Falar com o comercial no WhatsApp+55 11 5192-3351